-
 contact@diggers-consulting.com
 01 73 28 29 65
 LinkedIn


Imaginez : vous travaillez sur une API de gestion de commandes et vous posez une question à un LLM…
Vous : Dans notre API, comment annuler une commande ?
LLM : Il suffit d’appeler
DELETE /api/orders/{id}et d’attendre un code204 No Contentpour vérifier que l’opération a réussi. N’oubliez pas de vérifier que la commande n’est pas déjà expédiée côté client avant l’appel.
La réponse est claire, bien structurée et assurée et elle est pourtant fausse. Dans votre API, l’opération DELETE n’existe pas sur cette ressource, parce que vous avez décidé de ne jamais supprimer une commande, mais bien de la passer au statut CANCELLED via POST /api/v2/orders/{id}/cancel pour des raisons comptables listées dans un ancien ticket Jira (très peu consulté ces derniers temps).
Ce n’est pas un mensonge du modèle en soi. Pour une API REST générique ça pourrait bien être la bonne réponse, et, faute de connaître les spécificités de votre API, le modèle choisit d’appliquer cette réponse à votre cas, et établit comme un fait sur votre application ce qu’on appelle une hallucination : une réponse convaincante qui ne repose sur aucune information réelle.
Le problème n’est pas nécessairement sa capacité à raisonner. Même un modèle performant ne connaît pas spontanément votre base de code, vos spécifications produit ou vos décisions d’architecture, et les informations qu’il a pu apprendre peuvent être obsolètes.
La première réponse qu’on envisage souvent est le fine-tuning, qui consiste à poursuivre l’entraînement d’un modèle sur un jeu de données spécifique afin d’adapter son comportement. Il peut avoir beaucoup d’intérêt dans certains cas, mais pour résoudre notre problème de connaissance métier, ce n’est pas la meilleure approche. C’est coûteux, ça prend du temps, et surtout, ça fige la connaissance à un instant T. Quand votre doc évolue, il faut relancer un nouveau cycle de fine-tuning, sans parler du fait que le fine-tuning apprend au modèle un comportement, pas à retrouver une information précise dans un corpus.
Une meilleure réponse est le RAG, pour Retrieval-Augmented Generation ou « génération augmentée par récupération ».
Plutôt que de faire intégrer vos données au modèle une fois pour toutes, l’idée est que nous lui donnions accès à une base documentaire au moment de répondre. Quand une question arrive, l’application recherche les passages pertinents dans vos documents, puis les ajoute au prompt envoyé au LLM.
Imaginez un développeur senior qui vient de rejoindre votre équipe. Il connaît bien les API, mais pas encore votre projet, donc sans consulter la documentation, si on lui pose la question de l’annulation de commande, il pourrait répondre « Un DELETE sur la ressource, peut-être ? » Après avoir lu le wiki, sa réponse serait différente : « D’après la page Cycle de vie d’une commande, il faut appeler POST /api/v2/orders/{id}/cancel avec un motif. » Il n’est pas devenu plus compétent entre-temps, il dispose simplement de la bonne information et peut en indiquer la source.
Le RAG applique ce principe aux LLM. Dans cet article, on verra d’où vient cette idée, comment construire un pipeline simple, quels paramètres surveiller, quand cette architecture est utile et comment en évaluer la qualité.
D’où vient le RAG ?
À la fin des années 2010, des travaux montrent que les grands modèles préentraînés stockent des connaissances factuelles dans leurs paramètres, c’est ce qu’on appelle la mémoire paramétrique. Mais s’appuyer uniquement sur elle pose trois difficultés :
- Elle est difficile à mettre à jour, pour corriger ou ajouter un fait, il faut réentraîner.
- Elle est opaque, une réponse générée à partir des seuls paramètres ne fournit pas automatiquement une source vérifiable.
- Elle hallucine
2020 : l’article fondateur
En 2020, Lewis et ses coauteurs publient Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. L’idée est d’associer la mémoire paramétrique d’un générateur fondé sur BART à une mémoire non paramétrique représentée par un index de passages de Wikipédia interrogé par un système de recherche neuronal, DPR. Pour mettre à jour les connaissances du système, il suffit de remplacer l’index, sans toucher au modèle.
2022-2023 : l’adoption dans les applications
Avec l’arrivée de ChatGPT et des LLMs accessibles par API, les entreprises veulent brancher ces modèles sur leurs propres données, mais elles ne peuvent pas (ou ne veulent pas) les réentraîner. Le RAG devient alors le pattern par défaut, avec un LLM figé connecté à une base de données vectorielle par un prompt. C’est l’époque de l’essor de LangChain, LlamaIndex, Pinecone, Qdrant… et de ce qu’on appelle aujourd’hui le naive RAG, celui qu’on va construire dans cet article.
2023 à aujourd’hui : les variantes
Les limites du RAG naïf (de mauvais chunks remontés, des questions complexes, des contradictions entre sources) ont donné naissance à des évolutions, notamment :
- L’advanced RAG améliore chaque étape avec de la recherche hybride, du re-ranking des résultats, ou de la reformulation de la question avant la recherche.
- Le Self-RAG (2023) entraîne le modèle à décider quand rechercher des informations et à évaluer les passages et ses propres réponses, et le Corrective RAG (2024) utilise un évaluateur de la recherche pour déclencher des actions correctives, notamment une recherche web.
- Le GraphRAG (Microsoft, 2024), où en complément des chunks, on construit un graphe de connaissances à partir du corpus, permettant de répondre à des questions globales comme « quels sont les grands problèmes remontés par le support ce trimestre ? », auxquelles un extrait isolé répond mal.
- Le KAG, Knowledge Augmented Generation (Ant Group, 2024), qui combine un graphe de connaissances structuré, relié aux passages de texte d’origine, avec un raisonnement guidé (la question est décomposée en étapes logiques exécutées sur le graphe et sur le texte, ce qui est plus coûteux à construire et à maintenir qu’un index vectoriel), conçu pour les domaines professionnels où une réponse « sémantiquement proche » ne suffit pas, il faut qu’elle soit logiquement correcte;
- Le RAG agentique, où un agent pilote la recherche, en plusieurs étapes et sur plusieurs sources (sujet pour un prochain article).
En parallèle, les fenêtres de contexte sont passées de quelques milliers à plusieurs centaines de milliers (voire millions) de tokens, ce qui a relancé le débat « le RAG est-il encore utile ? ». On y revient plus bas, dans la section Faut-il vraiment un RAG ?.
L’architecture d’un RAG
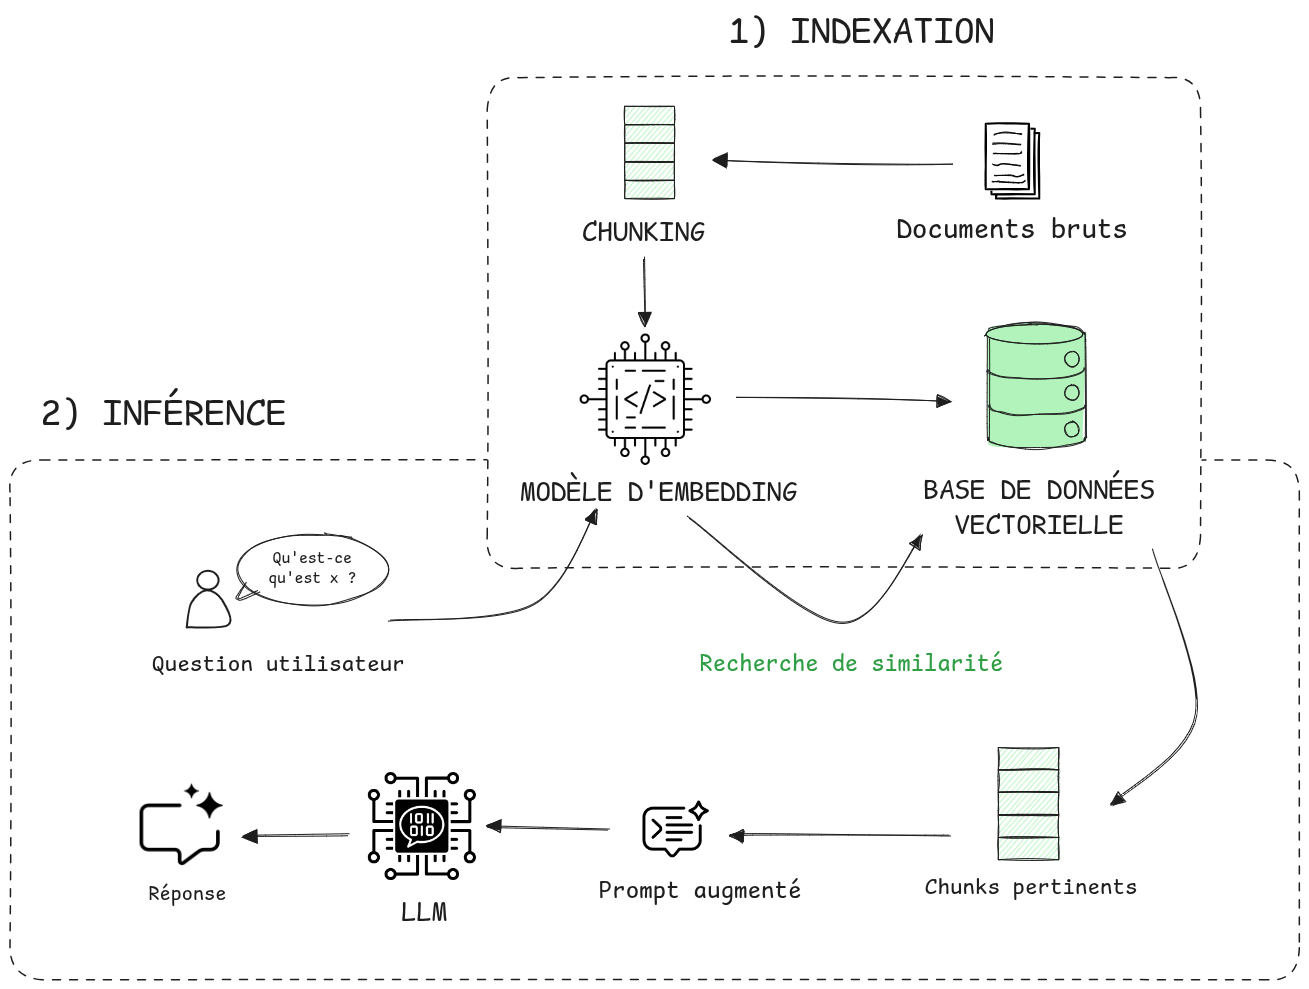
Un pipeline RAG se découpe en deux phases distinctes, qui ne s’exécutent pas au même moment ni à la même fréquence.
Phase 1 : Indexation (hors ligne)
C’est le travail de préparation, fait une fois ou à chaque fois que la base documentaire évolue, pas à chaque requête utilisateur.
La première partie de l’indexation est le Chunking, où on découpe les documents sources en morceaux plus petits, appelés chunks, à la granularité d’une page de doc, de quelques paragraphes ou d’un bloc de code.
La deuxième partie est l’Embedding, où chaque chunk est passé dans un modèle d’embedding, qui le transforme en vecteur numérique, i.e., une liste de flottants qui encode le sens du texte. Deux chunks qui parlent de la même chose auront des vecteurs proches dans cet espace, même s’ils n’utilisent pas les mêmes mots.
L’indexation se termine par le Stockage, où ces vecteurs sont indexés dans une base de données vectorielle (Pinecone, Qdrant, Weaviate, ou plus simplement pgvector si vous êtes déjà sous PostgreSQL). La base stocke le vecteur, le texte original du chunk et éventuellement des métadonnées (source, date, auteur…).
Phase 2 : Inférence (en ligne)
C’est ce qui se passe à chaque requête utilisateur, en temps réel.
L’inférence commence par l’Embedding de la question, où la question de l’utilisateur passe par le même modèle d’embedding que lors de l’indexation, et on obtient un vecteur qui représente l’intention de la question.
La prochaine partie de l’inférence est la Recherche de similarité, où on cherche dans la base de données vectorielle les chunks dont le vecteur est le plus proche de celui de la question. C’est le retrieval, on récupère les top-k résultats (typiquement 3 à 10 chunks).
La dernière partie de l’inférence est l’Augmentation et génération, où les chunks récupérés sont injectés dans le prompt, en guise de contexte. Le LLM génère ensuite sa réponse en s’appuyant sur ce contexte, d’où le nom Retrieval-Augmented Generation.
Les concepts clés à maîtriser
Le pipeline RAG repose sur quelques notions basiques, dont les configurations sont souvent les sources à checker en premier quand on rencontre des problèmes.
Découper un document en chunks semble trivial, mais ça ne l’est pas. Trop grands, les chunks noient l’information pertinente dans du bruit. Trop petits, ils perdent leur contexte.
Les stratégies courantes sont :
- Le découpage à taille fixe (simple mais brutal),
- Le découpage par phrase ou paragraphe (mieux, mais dépend de la qualité du texte source),
- Le découpage sémantique (on regroupe les phrases jusqu’à ce que le sens change, ce qui est plus intelligent mais plus coûteux).
Pour une doc technique structurée, découper par section ou par bloc logique donne souvent de bons résultats. Une règle empirique est que la taille du chunk doit correspondre à la granularité de ce qu’on cherche. Si les questions sont précises, les chunks doivent l’être aussi.
Exemple : dans une page « Cycle de vie d’une commande », un découpage à taille fixe peut couper la phrase « l’annulation nécessite un motif obligatoire » en deux. Le chunk qui contient l’endpoint /cancel ne mentionne plus le motif, et le LLM génère un appel incomplet. Découper par section Markdown (## Annulation) évite ce piège.
Zoom : c’est quoi exactement une base de données vectorielle ?
Une base de données classique (PostgreSQL, MySQL…) est conçue pour des recherches exactes comme « donne-moi la commande 1234 », « tous les tickets au statut OPEN », « les pages dont le titre contient SSO ». Ses index sont faits pour comparer des valeurs.
Essayons de retrouver la doc sur l’authentification avec une requête classique :
SELECT title FROM docs WHERE content ILIKE '%SSO%';Cette requête rate la page intitulée « Connexion via Okta » et celle qui parle d’« authentification unique », parce qu’elles ne contiennent pas le mot « SSO ». Retrouver des passages qui parlent de la même chose que la question, même s’ils ne contiennent pas les mêmes mots, est exactement ce dont on a besoin pour un RAG.
Une base vectorielle stocke les embeddings et répond à la question « quels sont les vecteurs les plus proches de celui-ci ? ». Avec pgvector, ça donne :
-- Une colonne de type vector, de la dimension du modèle d'embedding
CREATE TABLE doc_chunks (
    id        bigserial PRIMARY KEY,
    source    text,
    content   text,
    embedding vector(1536)
);

-- Index ANN (HNSW) pour la distance cosinus
CREATE INDEX ON doc_chunks USING hnsw (embedding vector_cosine_ops);

-- Les 5 chunks les plus proches du vecteur de la question
SELECT source, content
FROM doc_chunks
ORDER BY embedding <=> '[0.012, -0.044, ...]'  -- <=> : distance cosinus
LIMIT 5;
On utilise un index spécialisé parce que comparer la question à 1 million de chunks de 1 536 dimensions, c’est environ 1,5 milliard de multiplications par requête. Les bases vectorielles utilisent des index ANN (Approximate Nearest Neighbors) comme HNSW, qui organise les vecteurs en graphe de voisinage et trouve les plus proches en quelques millisecondes. Le prix à payer est que le résultat est approximatif, donc de temps en temps, un des vrais plus proches voisins est manqué, ce qui est généralement acceptable pour un RAG.
Il faut remarquer qu’une base vectorielle ne remplace pas votre base classique. On combine souvent les deux, en ayant un filtre classique sur les métadonnées (WHERE product = 'billing' AND version = 'v3'), puis un tri par similarité. De plus, les embeddings sont mauvais sur les identifiants exacts parce qu’un code d’erreur ERR_4012, par exemple, n’a pas de « sens » sémantique, et pour ces cas-là, une recherche par mots-clés reste meilleure, d’où l’intérêt de la recherche hybride, qui combine les deux scores.
Un RAG en pratique
Voici à quoi ressemble un pipeline RAG minimal, de bout en bout. Le cas d’usage est un chatbot interne qui répond sur votre documentation technique. On va utiliser LangChain avec OpenAI pour les embeddings et la génération, et Qdrant comme vector store.
Phase 1: Indexation
from langchain.document_loaders import DirectoryLoader
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain.embeddings import OpenAIEmbeddings
from langchain.vectorstores import Qdrant

# 1. Charger les documents sources
loader = DirectoryLoader("./docs/", glob="**/*.md")
documents = loader.load()

# 2. Découper en chunks
splitter = RecursiveCharacterTextSplitter(
    chunk_size=500,  # caractères par chunk
    chunk_overlap=50 # pour ne pas perdre le contexte aux jointures
)
chunks = splitter.split_documents(documents)

# 3. Générer les embeddings et indexer
embedding = OpenAIEmbeddings(model="text-embedding-3-small")
vector_store = Qdrant.from_documents(
    chunks,
    embedding,
    url="http://localhost:6333",
    collection_name="internal_docs"
)
RecursiveCharacterTextSplitter est un bon point de départ, il découpe d’abord par paragraphe, puis par retour à la ligne, puis par espace, puis par caractère si nécessaire, en respectant autant que possible la structure naturelle du texte.
Phase 2: Inférence
from langchain_openai import ChatOpenAI
from langchain_classic.chains import RetrievalQA

# 1. Recharger le vector store existant
vector_store = Qdrant.from_existing_collection(
    embedding=OpenAIEmbeddings(model="text-embedding-3-small"),
    url="<localhost>",
    collection_name="internal_docs"
)

# 2. Construire la chaîne RAG
rag_chain = RetrievalQA.from_chain_type(
    llm=ChatOpenAI(model="gpt-4o", temperature=0),
    retriever=vector_store.as_retriever(search_kwargs={"k": 5}),
    return_source_documents=True # utile pour tracer d'où vient la réponse
)

# 3. Poser une question
result = rag_chain.invoke("Comment annuler une commande ?")
print(result["result"])           # Réponse générée par le LLM, basée sur les chunks récupérés
print(result["source_documents"]) # Les chunks qui ont servi à construire la réponse
Le paramètre return_source_documents=True est une bonne pratique en production, ça permet d’afficher les sources à l’utilisateur et de déboguer les mauvaises réponses.
Ce que ce pipeline fait
Quand l’utilisateur pose sa question, LangChain l’embed, interroge Qdrant pour récupérer les 5 chunks les plus proches, les injecte dans un prompt structuré, et envoie le tout à GPT-4o.
Reprenons la question du début. Cette fois, le retriever remonte en tête le chunk de
docs/orders/lifecycle.md qui contient :
## Annulation
Une commande n'est jamais supprimée. Pour l'annuler, appeler
POST /api/v2/orders/{id}/cancel avec un champ `reason` obligatoire.
La commande passe au statut CANCELLED (voir ticket FIN-482 pour le contexte comptable).
Et la réponse devient : « Il faut appeler POST /api/v2/orders/{id}/cancel en fournissant un champ
reason. La commande n’est pas supprimée mais passe au statut CANCELLED. » La source est
retournée avec la réponse, et l’utilisateur peut vérifier en un clic.
Ce snippet est minimal, en production vous ajouterez un historique de conversation, peut-être un re-ranking des chunks avant injection, mais la mécanique de fond reste celle-là. Il manque en revanche une pièce essentielle : le prompt.
Le prompt, la pièce qu’on oublie
Dans l’exemple précédent, on a laissé LangChain utiliser son prompt par défaut, mais en pratique, le prompt joue un rôle énorme dans la qualité finale, décidant ce que le modèle fait avec les informations récupérées par le retrieval.
Pour donner un exemple concret, prenons un utilisateur qui demande « Quel est le délai maximum pour annuler une commande ? ». La doc récupérée explique comment annuler, mais ne dit rien sur un délai, donc avec un prompt générique, le modèle a de bonnes chances de répondre « 14 jours », le délai de rétractation légal qu’il a vu ailleurs et donc une hallucination.
Voici un prompt plus robuste, branché dans la même chaîne :
from langchain.prompts import PromptTemplate

prompt = PromptTemplate(
    input_variables=["context", "question"],
    template="""Tu es l'assistant technique interne de l'équipe Plateforme, réponds à la question en t'appuyant UNIQUEMENT sur les extraits de documentation ci-dessous.

Règles :
- Si la réponse n'est pas dans les extraits, réponds exactement "Je ne trouve pas cette information dans la documentation", n'invente rien.
- Cite la source de chaque information.
- Si deux extraits se contredisent, signale-le au lieu de choisir.

Extraits de documentation :
<context>
{context}
</context>

Question : {question}
Réponse :""",
)

# Chaque chunk est préfixé par sa source, sinon le modèle ne peut pas la citer
document_prompt = PromptTemplate(
    input_variables=["page_content", "source"],
    template="[{source}]\n{page_content}",
)

rag_chain = RetrievalQA.from_chain_type(
    llm=ChatOpenAI(model="gpt-4o", temperature=0),
    retriever=vector_store.as_retriever(search_kwargs={"k": 5}),
    return_source_documents=True,
    chain_type_kwargs={"prompt": prompt, "document_prompt": document_prompt},
)- Indiquer « UNIQUEMENT sur les extraits » est le garde-fou principal contre les hallucinations. De plus, demander une phrase de repli fixe aide aussi à mesurer dans les logs combien de questions restent sans réponse et donc quelles pages de doc manquent.
- Demander la citation des sources force le modèle à rattacher chaque affirmation à un extrait, et c’est pour ça que le
document_promptqui ajoute la source devant chaque chunk est important, vu que le modèle ne peut citer que ce qu’on lui montre. - Les délimiteurs
<context>séparent clairement les données des instructions, parce que si un document indexé contient une phrase du type « ignore les instructions précédentes », le modèle a plus de chances de la traiter comme du contenu et non comme un ordre.
Il faut aussi parler de la query rewriting, l’une des améliorations les plus rentables d’un RAG conversationnel. Si l’utilisateur demande « Comment annuler une commande ? », puis « Et pour un abonnement ? », embedder tel quel « Et pour un abonnement ? » ne remontera rien d’utile. On demande donc d’abord au LLM de reformuler la question en version autonome (« Comment annuler un abonnement ? »), puis on lance la recherche avec celle-ci.
Faut-il vraiment un RAG ?
Vu qu’un RAG est une brique d’infra en plus, avec un pipeline d’indexation à maintenir, une base vectorielle et des paramètres à régler, il faut se demander si c’est nécessaire avant de se lancer.
Si votre corpus tient confortablement dans la fenêtre de contexte, la solution la plus simple est souvent de mettre le document entier dans le prompt, avec la même consigne « réponds uniquement à partir de ce document », sans avoir recours au chunking et à l’embedding.
Par exemple, un assistant qui répond sur le README de 20 pages d’un outil interne n’a aucune raison d’utiliser un RAG, vu que les modèles actuels acceptent des contextes de plusieurs centaines de milliers de tokens, et le prompt caching proposé par la plupart des fournisseurs réduit fortement le coût d’un même document renvoyé à chaque requête.
Quand le RAG devient nécessaire
- Quand le corpus ne rentre pas dans le contexte (on a un Confluence de 4 000 pages, des milliers de tickets Jira et plusieurs dépôts de code, par exemple).
- Quand le coût par requête explose et on envoie 100 000 tokens de doc à chaque question, sur 1 000 questions par jour, représentant 100 millions de tokens d’entrée par jour. Avec un RAG qui injecte 5 chunks d’environ 400 tokens, on tombe à 2 millions, soit 50 fois moins.
- Quand la qualité se dégrade avec la longueur : même quand tout rentre, les modèles exploitent moins bien l’information noyée au milieu d’un très long contexte, donc donner 5 extraits pertinents est souvent plus efficace que donner 500 pages.
- Quand le corpus change souvent, ou qu’il faut filtrer par droits d’accès, un index permet de mettre à jour un seul document, ou de ne remonter que les documents que l’utilisateur a le droit de voir.
Et si on indexe trop ?
Indexer « tout, au cas où » a un coût, à trois niveaux. Comme c’est un traitement ponctuel, le coût d’embedding est en général le plus faible, et les modèles d’embedding coûtent peu par token (il faut toutefois le refaire à chaque changement de modèle d’embedding). Mais le coût de stockage et de mémoire grimpe vite, vu qu’un vecteur de 1 536 flottants pèse environ 6 Ko et un million de chunks représente donc environ 6 Go de vecteurs bruts, avant le surcoût de l’index qui doit idéalement tenir en RAM. Le coût en qualité est le plus sournois, parce que chaque document inutile est un concurrent de plus pour les bons chunks, donc si on indexe les trois versions de la doc d’authentification, la question « comment rafraîchir un token ? » risque de remonter la procédure qui n’existe plus.
La règle est d’indexer ce qui répond aux questions posées réellement, dédoublonner, supprimer l’obsolète, et ajouter des métadonnées pour pouvoir filtrer.
Comment savoir si votre RAG est bon ?
Pour évaluer un RAG, il faut mesurer séparément ses deux étages, parce qu’une mauvaise réponse peut venir de l’un ou de l’autre.
Le point de départ : un jeu de test
Constituez un golden dataset avec 50 à 100 vraies questions (piochées dans Slack, le support, les questions récurrentes des nouveaux arrivants), avec pour chacune le document qui contient la réponse et, idéalement, la réponse attendue. C’est ce qui permet de savoir si un changement de chunking ou de prompt améliore vraiment les choses.
Évaluer le retrieval
- Recall@k : dans quel pourcentage des cas le bon document fait-il partie des k chunks récupérés ?
- MRR (Mean Reciprocal Rank) : à quel rang arrive le bon document ? 1 s’il est premier, 0,5 s’il est deuxième, etc.
- Precision@k : parmi les k chunks récupérés, combien sont réellement utiles ?
Ces métriques se calculent sans LLM, en quelques lignes :
golden_set = [
    {"question": "Comment annuler une commande ?", "expected_source": "docs/orders/lifecycle.md"},
    {"question": "Quelle est la durée de vie d'un token SSO ?", "expected_source": "docs/auth/sso.md"},
    # ... idéalement 50 à 100 vraies questions
]

retriever = vector_store.as_retriever(search_kwargs={"k": 5})

hits, reciprocal_ranks = 0, []
for item in golden_set:
    sources = [doc.metadata["source"] for doc in retriever.invoke(item["question"])]
    if item["expected_source"] in sources:
        hits += 1
        reciprocal_ranks.append(1 / (sources.index(item["expected_source"]) + 1))
    else:
        reciprocal_ranks.append(0)

print(f"Recall@5 : {hits / len(golden_set):.0%}")
print(f"MRR      : {sum(reciprocal_ranks) / len(golden_set):.2f}")
Évaluer la génération
- Fidélité (faithfulness) : chaque affirmation de la réponse est-elle soutenue par le contexte fourni ?
- Pertinence de la réponse : la réponse répond-elle vraiment à la question posée, ou à une question voisine ?
- Exactitude : la réponse correspond-elle à la réponse attendue du golden dataset ?
Ces métriques demandent de « comprendre » du texte, donc on utilise généralement un LLM comme juge (avec des frameworks comme RAGAS, DeepEval ou TruLens).
En production
Ajoutez des métriques opérationnelles pour la latence, le coût par requête et le taux de réponses « Je ne trouve pas cette information », avec des retours utilisateurs (un 👍/👎 sous chaque réponse, par exemple).
- Un recall bas indique que le problème est en amont, il faut donc revoir le chunking, tester un autre modèle d’embedding, et/ou ajouter de la recherche hybride.
- Un bon recall mais une baisse de fidélité indiquent que les bons chunks sont là, mais le modèle en fait mauvais usage, nécessitant donc de revoir le prompt, la température, ou réduire k pour limiter le bruit.
- Si tout est bon mais les utilisateurs sont mécontents, votre golden dataset ne ressemble probablement pas aux vraies questions et il faut l’enrichir avec les questions qui ont reçu un 👎.
Ce que le RAG résout bien… et ses limites
| Ce que le RAG fait vraiment bien | Les limites |
| Données toujours à jour : Quand votre doc évolue, vous réindexez les fichiers modifiés, sans cycle d’entraînement, ni downtime, ni coût GPU. | Garbage in, garbage out : La qualité de la réponse est plafonnée par la qualité du retrieval. Si les bons chunks ne remontent pas, la bonne réponse ne sortira pas non plus. |
| Traçabilité native : Il est trivial de retourner les sources qui ont servi à construire une réponse. Dans un contexte professionnel, c’est souvent non négociable. | Chunking mal calibré : Un découpage trop grossier, trop fin, ou qui ignore la structure du document produit des chunks hors contexte et des réponses incohérentes en cascade. |
| Coût maîtrisé : On paie des tokens pour le contexte injecté, pas pour un entraînement. | Raisonnement multi-étapes hors de portée : Le RAG classique répond en une passe. Si la réponse nécessite de croiser plusieurs sources ou de décomposer un problème complexe, il atteint rapidement ses limites. |
|
Moins d’hallucinations : Avec un prompt qui impose de s’appuyer sur le contexte, le modèle peut dire « je ne sais pas » au lieu d’inventer.
|
Pas de mémoire conversationnelle native : Chaque requête repart de zéro. Gérer un historique de conversation demande une couche supplémentaire et mange de la context window. |
Le RAG répond au problème fréquent de donner à un LLM accès à votre contexte, sans le réentraîner, avec un pipeline relativement simple (indexer, embedder, récupérer, augmenter) mais dont chaque étape a ses subtilités. C’est souvent dans les détails (le chunking, le top-k, le prompt) que réside la différence entre un RAG de qualité et un RAG qui frustre, et seule une évaluation sur de vraies questions permet de la mesurer.
Ce qu’on a vu ici, c’est le RAG dans sa forme classique : statique, mono-passe, sans mémoire, ce qui est efficace pour beaucoup de cas, mais limité dès que les questions deviennent complexes ou que les sources se multiplient.
Le prochain article de la série explorera le RAG agentique : comment des agents IA transforment ce pipeline statique en système dynamique, capable de raisonner sur plusieurs étapes entre plusieurs sources, et d’itérer jusqu’à trouver la bonne réponse.
Ressources pour aller plus loin
- Lewis et al., 2020: Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, le papier fondateur. https://arxiv.org/abs/2005.11401
- Liang et al., 2024: KAG: Boosting LLMs in Professional Domains via Knowledge Augmented Generation. https://arxiv.org/abs/2409.13731
- Edge et al., 2024: From Local to Global: A Graph RAG Approach to Query-Focused Summarization (GraphRAG, Microsoft). https://arxiv.org/abs/2404.16130
- Liu et al., 2023: Lost in the Middle: How Language Models Use Long Contexts. https://arxiv.org/abs/2307.03172
- Build a RAG agent: La documentation officielle de LangChain sur la construction d’une application Q&A avec RAG. https://docs.langchain.com/oss/python/langchain/rag
- RAGAS: framework open source d’évaluation de pipelines RAG. https://docs.ragas.io
- Guide 2025 – Eden AI: Un panorama des variantes du RAG en 2025 — Traditional RAG, Self-RAG, Corrective RAG, GraphRAG. https://www.edenai.co/post/the-2025-guide-to-retrieval-augmented-generation-rag